ビッグデータは、意味の広い用語であり、データセットを指します。データセットは非常に大きく複雑なため、専用に設計されたハードウェアとソフトウェアツールによる処理が必要です。このデータセットは通常、テラバイト(TB)やエクサバイト(EB)のサイズです。これらのデータセットは、センサー、気候情報、雑誌、新聞、記事などの公開情報など、さまざまな情報源から収集されます。ビッグデータが生まれる他の例には、購入取引記録、ウェブログ、医療記録、軍事監視、ビデオおよび画像アーカイブ、大規模な電子商取引などがあります。
ビッグデータとビッグデータ分析が企業に与える影響への関心が高まっています。ビッグデータ分析は、大量のデータの中からパターン、相関関係、その他の有益な情報を見つけ出すプロセスであり、企業が変化に適応し、より賢明な意思決定を行うのに役立ちます。
1. Hadoop
Hadoopは、大量のデータを分散処理できるソフトウェアフレームワークです。そしてHadoopは、信頼性が高く、効率ので、スケーラブルな方法で処理を行います。Hadoopが信頼できるのは、計算要素とストレージが故障すると想定し、複数の作業データのコピーを維持して、故障したノードに対して処理を再配分できるようにしているからです。Hadoopが効率のなのは、並列方式で動作し、並列処理によって処理速度を向上させるからです。またHadoopはスケーラブルであり、PB(ペタバイト)級のデータを処理できます。さらに、Hadoopはコミュニティサーバーに依存しているため、コストが比較の低く、誰でも使用できます。
Hadoopは、ユーザーが簡単に構築および使用できる分散コンピューティングプラットフォームです。ユーザーはHadoop上で、大量のデータを処理するアプリケーションを簡単に開発・実行できます。主な利点は次のとおりです。
1. 高信頼性Hadoopがデータをビット単位で保存・処理する能力は、人々の信頼に値します。
2. 高い拡張性Hadoopは、利用可能なコンピュータクラスタ間でデータを分配し、計算タスクを完了します。これらのクラスタは、数千のノードに簡単に拡張できます。
3. 高効率性Hadoopはノード間でデータを動的に移動でき、各ノードの動的バランスを保つため、処理速度が非常に速くなります。
4. 高い耐障害性Hadoopはデータの複数のレプリカを自動的に保存し、失敗したタスクを自動的に再配分できます。
HadoopにはJava言語で書かれたフレームワークが付属しているため、Linux本番プラットフォームでの実行に非常に適しています。また、Hadoop上のアプリケーションはC++などの他の言語でも記述できます。
2. HPCC
HPCCとは、High Performance Computing and Communications(高性能計算と通信)の略称です。1993年、米国科学・工学・技術連邦調整評議会は、「グランドチャレンジプロジェクト:高性能計算と通信」という報告書を連邦議会に提出しました。これはHPCC計画と呼ばれる報告書であり、米国大統領の科学戦略プロジェクトです。その目的は、研究開発を強化することにより、いくつかの重要な科学技術上のチャレンジ問題を解決することです。HPCCは、米国が情報スーパーハイウェイを実現するために実施した計画であり、その実施には約100億ドルが費やされます。主な目標は、スケーラブルな計算システムと関連ソフトウェアを開発してテラビット級のネットワーク伝送性能をサポートすること、ギガビットネットワーク技術を開発すること、そして研究・教育機関とネットワーク接続機能を拡張することです。
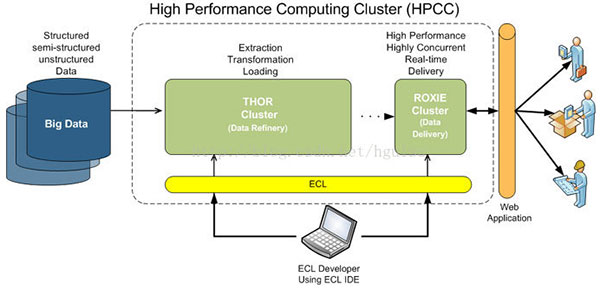
このプロジェクトは主に5つの部分から構成されています。
1. 高性能コンピュータシステム(HPCS)内容には、今後数世代のコンピュータシステムの研究、システム設計ツール、先進的な代表システム、既存システムの評価などが含まれます。
2. 先進的ソフトウェア技術とアルゴリズム(ASTA)内容には、グランドチャレンジ問題のソフトウェア支援、新しいアルゴリズムの設計、ソフトウェアの分岐とツール、計算科学、高性能計算研究センターなどが含まれます。
3. 国家研究教育ネットワーク(NREN)内容には、中継局と10億ビット級伝送の研究開発が含まれます。
4. 基礎研究と人的資源(BRHR)内容には、基礎研究、トレーニング、教育、カリキュラム教材が含まれます。これは、研究者主導の長期的な調査を奨励することで、スケーラブルな高性能計算における革新的なアイデアの流れを増やし、教育と高性能コンピューティングのトレーニングおよびコミュニケーションを向上させることで、熟練した訓練を受けた人材のプールを拡大し、これらの調査および研究活動を支援するために必要なインフラストラクチャを提供するように設計されています。
5. 情報基盤技術と応用(IITA)、その目的は、米国が先進的情報技術開発におけるリーダーシップを保証することです。
3. Storm
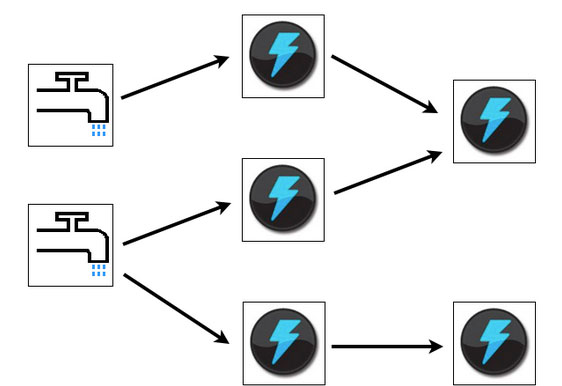
Stormはフリーのオープンソースソフトウェアであり、分散型でフォールトトレラントなリアルタイム計算システムです。Stormは非常に信頼性高く膨大なデータストリームを処理でき、Hadoopのバッチデータを処理するために使用されます。Stormはシンプルで、多くのプログラミング言語をサポートし、非常に楽しく使用できます。StormはTwitterによってオープンソース化されました。他の有名な利用企業には、Groupon、淘宝(タオバオ)、支付宝(アリペイ)、阿里巴巴(アリババ)、乐元素、Admasterなどがあります。
Stormには多くの応用分野があります。リアルタイム分析、オンラインマシンラーニング、ノンストップコンピューティング、分散RPC(遠隔手続き呼び出しプロトコル。ネットワークを介してリモートコンピュータのプログラムにサービスを要求する方法)、ETL(Extraction-Transformation-Loadingの略。データ抽出、変換、ロード)などです。Stormの処理速度は驚異的です。テストによると、各ノードは毎秒100万のデータタプルを処理できます。Stormは拡張可能でフォールトトレラントであり、セットアップと運用が簡単です。
4. Apache Drill
企業ユーザーがHadoopデータクエリをより効率的かつ高速化する方法を見つけるために、Apacheソフトウェア財団は最近、「Drill」というオープンソースプロジェクトを立ち上げました。Apache DrillはGoogleのDremelを実装しています。
Hadoopベンダーによると、MapR Technologies社のプロダクトマネージャーであるTomer Shiran氏の説明によると、「Drill」はすでにApacheインキュベータープロジェクトとして運営されており、世界中のソフトウェアエンジニアに向けて継続的に普及していく予定です。
このプロジェクトは、Google Dremel Hadoopツールのオープンソース版を生み出します(Googleはこのツールを使用して、Hadoopデータ分析ツールのインターネットアプリケーションを高速化しています)。そして「Drill」は、Hadoopユーザーが大量のデータセットをより迅速にクエリできるようにするのに役立ちます。
「Drill」プロジェクトは実際にはGoogleのDremelプロジェクトから着想を得ています。Dremelは、Googleが大量のデータセットの分析処理を実現するのに役立ちます。これには、Webドキュメントのクロール分析、Android Marketにインストールされたアプリケーションデータの追跡、スパムメールの分析、Google分散ビルドシステム上のテスト結果の分析などが含まれます。
「Drill」Apacheオープンソースプロジェクトを開発することで、組織はDrillに関連するAPIインターフェースと柔軟で強力なアーキテクチャを構築できる見込みがあります。これにより、幅広いデータソース、データ形式、クエリ言語のサポートが可能になります。
5. RapidMiner
RapidMinerは、世界をリードするデータマイニングソリューションであり、非常に高度な技術を備えています。そのデータマイニングタスクは広範囲にわたり、さまざまなデータアートを含み、データマイニングプロセスの設計と評価を簡素化できます。
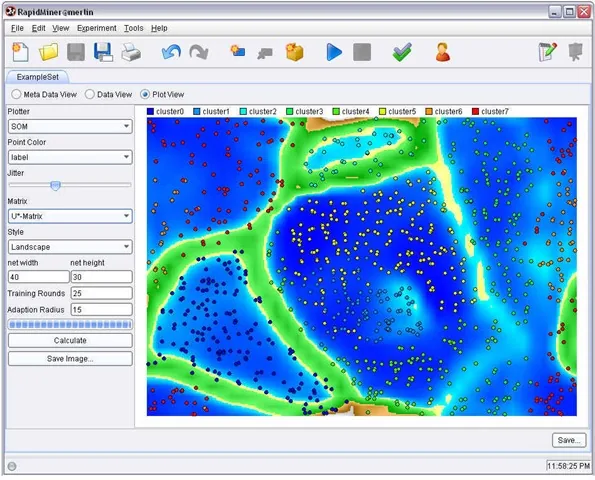
機能と特徴
- データマイニング技術とライブラリを無料で提供
- 100%Javaコード(オペレーティングシステム上で実行可能)
- データマイニングプロセスはシンプルで強力、かつ直感的です。
- 内部XMLにより、データマイニングプロセスを交換するための標準化された形式が保証されます。
- シンプルなスクリプト言語で大規模なプロセスを自動実行できます。
- 多層的なデータビューにより、効果的で透過的なデータを保証します。
- グラフィカルユーザーインターフェースのインタラクティブなプロトタイプ
- コマンドライン(バッチモード)での大規模な自動適用
- Java API(アプリケーションプログラミングインターフェース)
- シンプルなプラグインと拡張メカニズム
- 強力な可視化エンジン、多くの最先端の高次元データ可視化モデリング
- 400以上のデータマイニングオペレーターをサポート
イェール大学では、テキストマイニング、マルチメディアマイニング、機能設計、データストリームマイニング、統合開発方法、分散データマイニングなど、多くの異なる応用分野で成功裏に適用されています。
6. Pentaho BI
Pentaho BIプラットフォームは従来のBI製品とは異なり、プロセス中心でソリューション(Solution)指向のフレームワークです。その目的は、一連のエンタープライズ級BI製品、オープンソースソフトウェア、APIなどのコンポーネントを統合して、ビジネスインテリジェンスアプリケーションの開発を容易にすることです。その登場により、Jfree、Quartzなどの一連のビジネスインテリジェンス向け独立製品を統合して、複雑で完全なビジネスインテリジェンスソリューションを構成できるようになりました。
Pentaho BIプラットフォームは、Pentaho Open BIスイートのコアアーキテクチャおよび基盤であり、プロセス中心です。なぜなら、その中枢コントローラがワークフローエンジンであるからです。ワークフローエンジンはプロセス定義を使用して、BIプラットフォーム上で実行されるビジネスインテリジェンスプロセスを定義します。プロセスは簡単にカスタマイズでき、新しいプロセスを追加することもできます。BIプラットフォームには、これらのプロセスのパフォーマンスを分析するためのコンポーネントとレポートが含まれています。現在、Pentahoの主な構成要素には、レポート生成、分析、データマイニング、ワークフロー管理などが含まれます。これらのコンポーネントは、J2EE、WebService、SOAP、HTTP、Java、JavaScript、Portalsなどの技術を通じてPentahoプラットフォームに統合されています。Pentahoのリリースは、主にPentaho SDKの形式で行われます。
Pentaho SDKには全部で5つの部分が含まれています:Pentahoプラットフォーム、Pentahoサンプルデータベース、スタンドアロンで実行可能なPentahoプラットフォーム、Pentahoソリューションサンプル、および事前構成済みのPentaho Webサーバーです。その中でPentahoプラットフォームはPentahoプラットフォームの主要な部分であり、Pentahoプラットフォームのソースコードの本体を含みます。PentahoデータベースはPentahoプラットフォームの正常な動作にデータサービスを提供し、構成情報やSolution関連の情報などを含みますが、Pentahoプラットフォームにとって必須ではなく、構成によって他のデータベースサービスに置き換えることができます。スタンドアロンで実行可能なPentahoプラットフォームは、Pentahoプラットフォームのスタンドアロン実行モードのサンプルであり、アプリケーションサーバーのサポートなしでPentahoプラットフォームを独立して実行する方法を示しています。
PentahoソリューションサンプルはEclipseプロジェクトであり、Pentahoプラットフォーム向けのビジネスインテリジェンスソリューションを開発する方法を示すためのものです。
Pentaho BIプラットフォームは、サーバー、エンジン、コンポーネントの上に構築されています。これらは、システムのJ2EEサーバー、セキュリティ、ポータル、ワークフロー、ルールエンジン、チャート、コラボレーション、コンテンツ管理、データ統合、分析、およびモデリング機能を提供します。これらのコンポーネントのほとんどは標準ベースであり、他の製品に置き換えることができます。
著者:経緯方略
出典:http://www.36dsj.com/archives/22617