Big Data ist ein weit gefasster Begriff, der sich auf Datensätze bezieht, die so groß und komplex sind, dass sie speziell entwickelte Hardware- und Softwarewerkzeuge für die Verarbeitung erfordern. Solche Datensätze sind normalerweise Terabyte oder Exabyte groß. Diese Datensätze werden aus einer Vielzahl von Quellen gesammelt: Sensoren, Klimainformationen, öffentliche Informationen wie Zeitschriften, Zeitungen und Artikel. Weitere Beispiele für die Erzeugung von Big Data sind Kauf-Transaktionsdatensätze, Web-Logs, medizinische Aufzeichnungen, militärische Überwachung, Video- und Bildarchive sowie groß angelegter E-Commerce.
Es gibt einen starken Anstieg des Interesses an Big Data und Big-Data-Analytik und deren Auswirkungen auf Unternehmen. Big-Data-Analytik ist der Prozess der Untersuchung großer Datenmengen, um Muster, Korrelationen und andere nützliche Informationen zu finden, die Unternehmen helfen können, sich besser an Veränderungen anzupassen und klügere Entscheidungen zu treffen.
1. Hadoop
Hadoop ist ein Software-Framework, das verteilte Verarbeitung großer Datenmengen durchführen kann. Allerdings verarbeitet Hadoop Daten auf zuverlässige, effiziente und skalierbare Weise. Hadoop ist zuverlässig, weil es davon ausgeht, dass Rechenelemente und Speicher ausfallen werden, sodass es mehrere Kopien der Arbeitsdaten verwaltet und sicherstellt, dass die Verarbeitung auf ausgefallene Knoten umverteilt werden kann. Hadoop ist effizient, weil es parallel arbeitet und die Verarbeitung durch Parallelverarbeitung beschleunigt. Hadoop ist außerdem skalierbar und kann Daten im PB-Bereich verarbeiten. Darüber hinaus setzt Hadoop auf Community-Server, sodass die Kosten relativ niedrig sind und jeder es nutzen kann.
Hadoop ist eine verteilte Computing-Plattform, die es Benutzern ermöglicht, sie einfach zu entwerfen und zu nutzen. Benutzer können einfach Anwendungen entwickeln und ausführen, die riesige Datenmengen auf Hadoop verarbeiten. Sie bietet hauptsächlich die folgenden Vorteile:
1. Hohe Zuverlässigkeit.Hadoops Fähigkeit, Daten zu speichern und zu verarbeiten, ist vertrauenswürdig.
2. Hohe Skalierbarkeit. Hadoop verteilt Daten unter den verfügbaren Computerclustern und erledigt Rechenaufgaben. Diese Cluster können leicht auf Tausende von Knoten erweitert werden.
3. Hohe Effizienz. Hadoop kann Daten dynamisch zwischen Knoten verschieben und einen dynamischen Ausgleich zwischen den Knoten sicherstellen, sodass die Verarbeitungsgeschwindigkeit sehr hoch ist.
4. Hohe Fehlertoleranz. Hadoop kann automatisch mehrere Kopien von Daten speichern und fehlgeschlagene Aufgaben automatisch neu zuweisen.
Hadoop wird mit einem in Java geschriebenen Framework geliefert, daher ist es ideal für den Betrieb auf Linux-Produktionsplattformen. Anwendungen auf Hadoop können auch in anderen Sprachen geschrieben werden, wie z. B. C++.
2. HPCC
HPCC, Abkürzung für High Performance Computing and Communications. Im Jahr 1993 legte der Federal Coordinating Council for Science, Engineering, and Technology dem Kongress den Bericht „Grand Challenges: High Performance Computing and Communications“ vor, auch bekannt als HPCC-Plan, das strategische Wissenschaftsprojekt des US-Präsidenten. Sein Zweck ist es, eine Reihe wichtiger wissenschaftlicher und technologischer Herausforderungen durch verstärkte Forschung und Entwicklung zu lösen. HPCC ist ein von den Vereinigten Staaten umgesetzter Plan für die Datenautobahn. Die Umsetzung dieses Plans wird Dutzende Milliarden Dollar kosten. Seine Hauptziele sind: Entwicklung skalierbarer Computersysteme und zugehöriger Software zur Unterstützung der Netzwerkübertragungsleistung auf Terabit-Ebene, Entwicklung von Gigabit-Netzwerktechnologie und Ausbau von Forschungs- und Bildungseinrichtungen sowie der Netzwerkkonnektivitätsfähigkeiten.
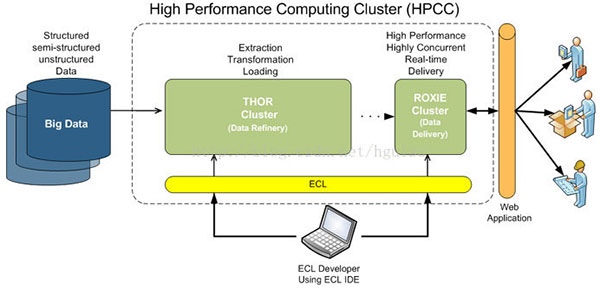
Das Projekt besteht hauptsächlich aus fünf Teilen:
1. High Performance Computer Systems (HPCS), einschließlich Forschung zu zukünftigen Generationen von Computersystemen, Systementwurfswerkzeugen, fortgeschrittenen typischen Systemen und Bewertung bestehender Systeme;
2. Advanced Software Technology and Algorithms (ASTA), einschließlich Softwareunterstützung für Grand-Challenge-Probleme, Entwurf neuer Algorithmen, Softwarezweige und -werkzeuge, Forschungszentren für Computational Science und High-Performance-Computing usw.;
3. National Research and Education Network (NREN), einschließlich Forschung und Entwicklung von Zwischenstationen und Gigabit-Übertragung;
4. Grundlagenforschung und Humanressourcen (BRHR), einschließlich Grundlagenforschung, Ausbildung, Bildung und Kursmaterialien, mit dem Ziel, den Fluss innovativer Ideen zu erhöhen, indem von Forschern initiierte, langfristige Forschung im Bereich des skalierbaren Hochleistungsrechnens belohnt wird; den Pool an qualifizierten und geschulten Fachkräften zu erweitern, indem Bildung sowie Schulung und Kommunikation im Hochleistungsrechnen verbessert werden; und die notwendige Infrastruktur bereitzustellen, um diese Forschungs- und Untersuchungsaktivitäten zu unterstützen;
5. Technologie und Anwendungen der Informationsinfrastruktur (IITA), mit dem Ziel, die Führungsrolle der USA bei der Entwicklung fortschrittlicher Informationstechnologie zu sichern.
3. Storm
Storm ist freie Open-Source-Software, ein verteiltes, fehlertolerantes Echtzeit-Computingsystem. Storm kann sehr zuverlässig riesige Datenströme verarbeiten und wird verwendet, um Hadoop-Batch-Daten zu verarbeiten. Storm ist einfach, unterstützt viele Programmiersprachen und macht Spaß bei der Nutzung. Storm wurde von Twitter als Open Source freigegeben. Weitere bekannte Anwendungsunternehmen sind Groupon, Taobao, Alipay, Alibaba, Happy Elements, Admaster usw.
Storm hat viele Anwendungsbereiche: Echtzeit-Analysen, Online-Maschinelles Lernen, kontinuierliche Berechnung, verteiltes RPC (Remote Procedure Call-Protokoll, eine Möglichkeit, Dienste von einem entfernten Computerprogramm über ein Netzwerk anzufordern), ETL (Extraction-Transformation-Loading, d. h. Datenextraktion, -transformation und -laden) und so weiter. Die Verarbeitungsgeschwindigkeit von Storm ist erstaunlich: getestet mit der Verarbeitung von 1 Million Daten-Tupeln pro Sekunde pro Knoten. Storm ist skalierbar, fehlertolerant und einfach einzurichten und zu betreiben.
4. Apache Drill
Um Unternehmensanwendern zu helfen, effektivere Möglichkeiten zur Beschleunigung von Hadoop-Datenabfragen zu finden,hat die Apache Software Foundationkürzlich ein Open-Source-Projekt namens „Drill“ gestartet. Apache Drill implementiert Googles Dremel.
Laut Hadoop-AnbieterMapR Tomer Shiran, Produktmanager bei Technologies, sagte, dass „Drill“ bereits als Apache-Inkubatorprojekt läuft und weltweit kontinuierlich Softwareingenieuren vorgestellt wird.
Das Projekt wird eine Open-Source-Version von Googles Dremel-Hadoop-Tool erstellen (Google verwendet dieses Tool, um Internetanwendungen von Hadoop-Datenanalysetools zu beschleunigen). Und „Drill“ wird Hadoop-Nutzern helfen, das Ziel zu erreichen, riesige Datensätze schneller abzufragen.
Das Projekt „Drill“ ist tatsächlich von Googles Dremel-Projekt inspiriert: Dieses Projekt hilft Google, riesige Datensätze zu analysieren und zu verarbeiten, einschließlich der Analyse gecrawlter Webdokumente, der Verfolgung von auf dem Android Market installierten Anwendungsdaten, der Spam-Analyse, der Analyse von Testergebnissen auf Googles verteiltem Build-System und so weiter.
Durch die Entwicklung des Apache-Open-Source-Projekts „Drill“ werden Organisationen in der Lage sein, die API-Schnittstellen und die flexible und leistungsstarke Architektur, zu der Drill gehört, einzurichten und dadurch dazu beitragen, eine breite Palette von Datenquellen, Datenformaten und Abfragesprachen zu unterstützen.
5. RapidMiner
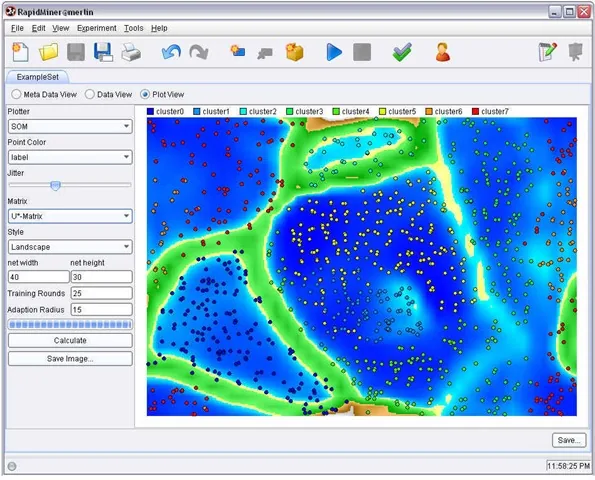
RapidMiner ist eine weltweit führende Data-Mining-Lösung mit in sehr hohem Maße fortschrittlicher Technologie. Sie deckt ein breites Spektrum von Data-Mining-Aufgaben ab, einschließlich verschiedener Datenkünste, und kann das Design und die Bewertung von Data-Mining-Prozessen vereinfachen.
Funktionen und Eigenschaften
- Kostenlose Bereitstellung von Data-Mining-Techniken und -Bibliotheken
- 100% in Java-Code geschrieben (kann auf Betriebssystemen ausgeführt werden)
- Data-Mining-Prozess ist einfach, leistungsstark und intuitiv
- Internes XML garantiert ein standardisiertes Format zur Darstellung und zum Austausch von Data-Mining-Prozessen
- Groß angelegte Prozesse können mit einfachen Skriptsprachen automatisiert werden
- Mehrstufige Datenansichten gewährleisten effektive und transparente Daten
- Interaktives Prototyping mit grafischer Benutzeroberfläche
- Kommandozeile (Batch-Modus) für automatisierte Anwendungen im großen Maßstab
- Java-API (Anwendungsprogrammierschnittstelle)
- Einfache Plugin- und Promotion-Mechanismen
- Leistungsstarke Visualisierungs-Engine, viele modernste Visualisierungsmodellierungen für hochdimensionale Daten
- Unterstützung für mehr als 400 Data-Mining-Operatoren
Die Yale University hat es erfolgreich in vielen verschiedenen Anwendungsfeldern eingesetzt, darunter Text-Mining, Multimedia-Mining, Feature-Design, Data-Stream-Mining, integrierte Entwicklungsmethoden und verteiltes Data-Mining.
6. Pentaho BI
Die Pentaho-BI-Plattform unterscheidet sich von traditionellen BI-Produkten. Sie ist ein prozesszentriertes, lösungsorientiertes Framework. Ihr Zweck ist es, eine Reihe von BI-Produkten auf Unternehmensebene, Open-Source-Software, APIs und andere Komponenten zu integrieren, um die Entwicklung von Business-Intelligence-Anwendungen zu erleichtern. Ihr Aufkommen ermöglicht es, eine Reihe unabhängiger BI-orientierter Produkte wie Jfree, Quartz usw. gemeinsam zu integrieren, um komplexe, vollständige Business-Intelligence-Lösungen zu bilden.
Die Pentaho-BI-Plattform, die Kernarchitektur und Grundlage der Pentaho Open BI Suite, ist prozesszentriert, weil ihr zentraler Controller eine Workflow-Engine ist. Die Workflow-Engine verwendet Prozessdefinitionen, um Business-Intelligence-Prozesse zu definieren, die auf der BI-Plattform ausgeführt werden. Prozesse können einfach angepasst und neue Prozesse hinzugefügt werden. Die BI-Plattform umfasst Komponenten und Berichte, um die Leistung dieser Prozesse zu analysieren. Derzeit umfassen die Hauptkomponenten von Pentaho Berichtsgenerierung, Analyse, Data-Mining, Workflow-Management und so weiter. Diese Komponenten werden über Technologien wie J2EE, WebService, SOAP, HTTP, Java, JavaScript und Portale in die Pentaho-Plattform integriert. Pentaho wird hauptsächlich in Form des Pentaho SDK vertrieben.
Das Pentaho SDK enthält fünf Teile: die Pentaho-Plattform, die Pentaho-Beispieldatenbank, die eigenständig laufende Pentaho-Plattform, die Pentaho-Lösungsbeispiele und einen vorkonfigurierten Pentaho-Webserver. Unter ihnen ist die Pentaho-Plattform der wichtigste Teil der Pentaho-Plattform und umfasst den Hauptteil des Quellcodes der Pentaho-Plattform; die Pentaho-Datenbank stellt Datendienste für den normalen Betrieb der Pentaho-Plattform bereit, einschließlich Konfigurationsinformationen, Solution-bezogenen Informationen usw. Sie ist für die Pentaho-Plattform nicht erforderlich und kann durch Konfiguration durch andere Datenbankdienste ersetzt werden; die eigenständig laufende Pentaho-Plattform ist ein Beispiel für den eigenständigen Betriebsmodus der Pentaho-Plattform und zeigt, wie die Pentaho-Plattform unabhängig ohne Anwendungsserverunterstützung ausgeführt wird.
Das Pentaho-Lösungsbeispiel ist ein Eclipse-Projekt, das demonstriert, wie verwandte Business-Intelligence-Lösungen für die Pentaho-Plattform entwickelt werden.
Die Pentaho BI-Plattform basiert auf Servern, Engines und Komponenten. Diese stellen die J2EE-Server-, Sicherheits-, Portal-, Workflow-, Regelengine-, Diagramm-, Kollaborations-, Content-Management-, Datenintegrations-, Analyse- und Modellierungsfunktionen des Systems bereit. Die meisten dieser Komponenten basieren auf Standards und können durch andere Produkte ersetzt werden.
Autor: Jingwei Fanglue
Quelle: http://www.36dsj.com/archives/22617