Le big data est un terme général qui désigne des ensembles de données si volumineux et complexes qu'ils nécessitent des outils matériels et logiciels spécialement conçus pour leur traitement. Ces ensembles de données atteignent généralement des téraoctets ou des exaoctets. Ces ensembles de données sont collectés à partir de diverses sources : capteurs, informations climatiques, informations publiques telles que magazines, journaux et articles. D'autres exemples de génération de big data incluent les enregistrements de transactions d'achat, les journaux web, les dossiers médicaux, la surveillance militaire, les archives vidéo et image, et le commerce électronique à grande échelle.
Il y a un engouement croissant pour le big data et l'analyse du big data ainsi que pour leur impact sur les entreprises. L'analyse du big data est le processus consistant à étudier de grandes quantités de données afin de trouver des modèles, des corrélations et d'autres informations utiles qui peuvent aider les entreprises à mieux s'adapter aux changements et à prendre des décisions plus intelligentes.
1. Hadoop
Hadoop est un framework logiciel qui peut effectuer un traitement distribué de grandes quantités de données. Cependant, Hadoop traite les données de manière fiable, efficace et évolutive. Hadoop est fiable parce qu'il suppose que les éléments de calcul et de stockage tomberont en panne, il conserve donc plusieurs copies des données de travail, ce qui garantit que le traitement peut être redistribué vers les nœuds défaillants. Hadoop est efficace parce qu'il fonctionne de manière parallèle, accélérant le traitement grâce au traitement parallèle. Hadoop est également évolutif et peut gérer des données de niveau PB. En outre, Hadoop s'appuie sur des serveurs communautaires, donc son coût est relativement faible et tout le monde peut l'utiliser.
Hadoop est une plateforme de calcul distribué que les utilisateurs peuvent facilement architecturer et utiliser. Les utilisateurs peuvent facilement développer et exécuter des applications qui traitent des quantités massives de données sur Hadoop. Il présente principalement les avantages suivants :
1. Haute fiabilité.La capacité de Hadoop à stocker et traiter des données est fiable.
2. Haute évolutivité. Hadoop répartit les données entre les clusters informatiques disponibles et exécute les tâches de calcul. Ces clusters peuvent être facilement étendus à des milliers de nœuds.
3. Haute efficacité. Hadoop peut déplacer dynamiquement les données entre les nœuds et assurer un équilibrage dynamique entre les nœuds, de sorte que la vitesse de traitement est très rapide.
4. Haute tolérance aux pannes. Hadoop peut automatiquement conserver plusieurs copies des données et réaffecter automatiquement les tâches échouées.
Hadoop est fourni avec un framework écrit en Java, il est donc idéal de l'exécuter sur des plateformes de production Linux. Les applications sur Hadoop peuvent également être écrites dans d'autres langages, tels que C++.
2. HPCC
HPCC, abréviation de High Performance Computing and Communications. En 1993, le Federal Coordinating Council for Science, Engineering, and Technology a soumis au Congrès le rapport « Grand Challenges: High Performance Computing and Communications », également connu sous le nom de plan HPCC, qui est le projet scientifique stratégique du président des États-Unis. Son objectif est de résoudre un certain nombre de défis scientifiques et technologiques importants en renforçant la recherche et le développement. HPCC est un plan mis en œuvre par les États-Unis pour l'autoroute de l'information. La mise en œuvre de ce plan coûtera des dizaines de milliards de dollars. Ses principaux objectifs sont : développer des systèmes informatiques évolutifs et des logiciels associés pour prendre en charge des performances de transmission réseau de niveau térabit, développer la technologie des réseaux gigabit, et développer les capacités des institutions de recherche et d'éducation et de connectivité réseau.
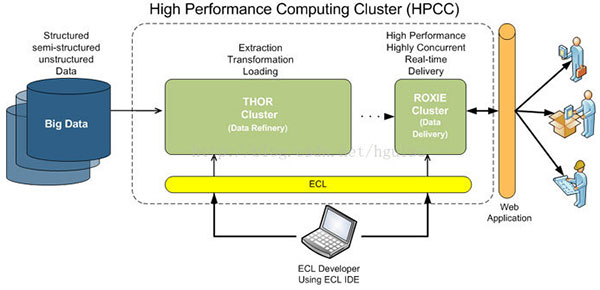
Le projet se compose principalement de cinq parties :
1. Systèmes informatiques à haute performance (HPCS), y compris la recherche sur les générations futures de systèmes informatiques, les outils de conception de systèmes, les systèmes typiques avancés et l'évaluation des systèmes existants ;
2. Technologies logicielles avancées et algorithmes (ASTA), y compris le support logiciel pour les grands problèmes difficiles, la conception de nouveaux algorithmes, les branches et outils logiciels, les centres de recherche en science computationnelle et en calcul haute performance, etc. ;
3. Réseau national de recherche et d'éducation (NREN), y compris la recherche et le développement de stations intermédiaires et de transmission de niveau gigabit ;
4. Recherche fondamentale et ressources humaines (BRHR), y compris la recherche fondamentale, la formation, l'éducation et les supports de cours, visant à accroître le flux d'idées innovantes en récompensant la recherche à long terme initiée par les chercheurs dans le calcul haute performance évolutif ; à élargir le vivier de personnel qualifié et formé en améliorant l'éducation et la formation en calcul haute performance ainsi que les communications ; et à fournir l'infrastructure nécessaire pour soutenir ces activités de recherche et d'investigation ;
5. Technologies et applications des infrastructures d'information (IITA), dans le but d'assurer le leadership des États-Unis dans le développement des technologies de l'information avancées.
3. Storm
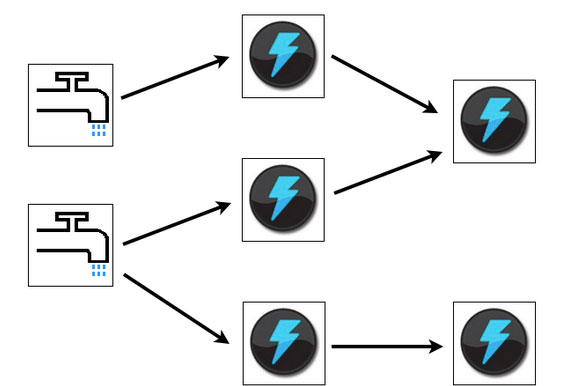
Storm est un logiciel libre et open source, un système de calcul en temps réel distribué et tolérant aux pannes. Storm peut traiter de manière très fiable d'énormes flux de données et est utilisé pour traiter les données par lots Hadoop. Storm est simple, prend en charge de nombreux langages de programmation et est agréable à utiliser. Storm a été rendu open source par Twitter. Parmi les autres entreprises d'application bien connues figurent Groupon, Taobao, Alipay, Alibaba, Happy Elements, Admaster, etc.
Storm a de nombreux domaines d'application : analyse en temps réel, apprentissage automatique en ligne, calcul continu, RPC distribué (Remote Procedure Call protocol, un moyen de demander des services à un programme informatique distant via un réseau), ETL (Extraction-Transformation-Loading, c'est-à-dire extraction, transformation et chargement des données), etc. La vitesse de traitement de Storm est impressionnante : testée pour traiter 1 million de tuples de données par seconde et par nœud. Storm est évolutif, tolérant aux pannes et facile à installer et à exploiter.
4. Apache Drill
Afin d'aider les utilisateurs d'entreprise à trouver des moyens plus efficaces d'accélérer les requêtes de données Hadoop,l'Apache Software Foundationa récemment lancé un projet open source appelé "Drill". Apache Drill implémente Dremel de Google.
Selon le fournisseur HadoopMapR Tomer Shiran, chef de produit chez Technologies, a déclaré que « Drill » fonctionne déjà comme un projet incubateur Apache et sera continuellement promu auprès des ingénieurs logiciels du monde entier.
Le projet créera une version open source de l'outil Hadoop Dremel de Google (Google utilise cet outil pour accélérer les applications Internet des outils d'analyse de données Hadoop). Et « Drill » aidera les utilisateurs de Hadoop à atteindre l'objectif d'interroger plus rapidement des ensembles de données massifs.
Le projet « Drill » s'inspire en réalité du projet Dremel de Google : ce projet aide Google à analyser et traiter des ensembles de données massifs, notamment en analysant des documents web explorés, en suivant les données d'applications installées sur Android Market, en analysant le spam, en analysant les résultats de tests sur le système de build distribué de Google, etc.
En développant le projet open source Apache « Drill », les organisations pourront établir les interfaces API et l'architecture flexible et puissante à laquelle appartient Drill, contribuant ainsi à prendre en charge un large éventail de sources de données, de formats de données et de langages de requête.
5. RapidMiner
RapidMiner est une solution de fouille de données leader mondial avec une technologie avancée dans une très large mesure. Elle couvre un large éventail de tâches de fouille de données, y compris divers arts de données, et peut simplifier la conception et l'évaluation des processus de fouille de données.
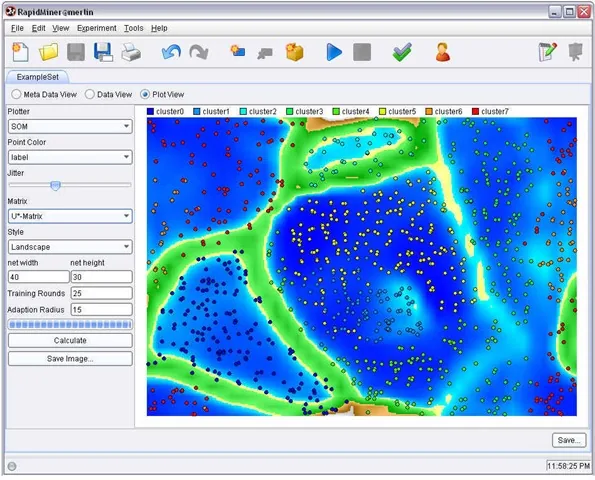
Fonctionnalités et caractéristiques
- Mise à disposition gratuite de techniques et de bibliothèques de fouille de données
- 100% écrit en code Java (peut s'exécuter sur les systèmes d'exploitation)
- Le processus de fouille de données est simple, puissant et intuitif
- Le XML interne garantit un format standardisé pour représenter et échanger des processus de fouille de données
- Les processus à grande échelle peuvent être automatisés avec de simples langages de script
- Les vues de données multi-niveaux garantissent des données efficaces et transparentes
- Prototypage interactif avec interface utilisateur graphique
- Ligne de commande (mode batch) pour des applications automatisées à grande échelle
- API Java (interface de programmation d'application)
- Mécanismes simples de plugin et de promotion
- Moteur de visualisation puissant, de nombreuses modélisations de visualisation de pointe pour les données à haute dimension
- Prise en charge de plus de 400 opérateurs de fouille de données
L'université Yale l'a appliqué avec succès dans de nombreux domaines d'application différents, notamment la fouille de textes, la fouille multimédia, la conception de fonctionnalités, la fouille de flux de données, les méthodes de développement intégrées et la fouille de données distribuée.
6. Pentaho BI
La plateforme Pentaho BI est différente des produits BI traditionnels. C'est un framework centré sur les processus et orienté solution. Son objectif est d'intégrer une série de produits BI d'entreprise, de logiciels open source, d'API et d'autres composants afin de faciliter le développement d'applications d'informatique décisionnelle. Son apparition permet d'intégrer ensemble une série de produits indépendants orientés BI tels que Jfree, Quartz, etc. pour former des solutions d'informatique décisionnelle complexes et complètes.
La plateforme Pentaho BI, architecture centrale et fondement de la suite Pentaho Open BI, est centrée sur les processus parce que son contrôleur central est un moteur de workflow. Le moteur de workflow utilise des définitions de processus pour définir les processus d'informatique décisionnelle exécutés sur la plateforme BI. Les processus peuvent être facilement personnalisés, et de nouveaux processus peuvent être ajoutés. La plateforme BI comprend des composants et des rapports pour analyser les performances de ces processus. Actuellement, les principaux composants de Pentaho comprennent la génération de rapports, l'analyse, la fouille de données, la gestion des workflows, etc. Ces composants sont intégrés dans la plateforme Pentaho via des technologies telles que J2EE, WebService, SOAP, HTTP, Java, JavaScript et Portals. Pentaho est principalement distribué sous la forme du Pentaho SDK.
Le SDK Pentaho contient cinq parties : la plateforme Pentaho, la base de données d'exemple Pentaho, la plateforme Pentaho autonome, les exemples de solutions Pentaho et un serveur web Pentaho préconfiguré. Parmi elles, la plateforme Pentaho est la partie la plus importante de la plateforme Pentaho, englobant le corps principal du code source de la plateforme Pentaho ; la base de données Pentaho fournit des services de données pour le fonctionnement normal de la plateforme Pentaho, y compris les informations de configuration, les informations liées aux solutions, etc. Elle n'est pas nécessaire à la plateforme Pentaho et peut être remplacée par d'autres services de base de données via la configuration ; la plateforme Pentaho autonome est un exemple du mode d'exécution autonome de la plateforme Pentaho, montrant comment exécuter la plateforme Pentaho indépendamment sans prise en charge d'un serveur d'applications.
L'exemple de solution Pentaho est un projet Eclipse utilisé pour montrer comment développer des solutions d'informatique décisionnelle connexes pour la plateforme Pentaho.
La plateforme Pentaho BI est construite sur des serveurs, des moteurs et des composants. Ceux-ci fournissent les fonctions de serveur J2EE, de sécurité, de portail, de workflow, de moteur de règles, de graphiques, de collaboration, de gestion de contenu, d'intégration de données, d'analyse et de modélisation du système. La plupart de ces composants sont basés sur des standards et peuvent être remplacés par d'autres produits.
Auteur : Jingwei Fanglue
Source : http://www.36dsj.com/archives/22617